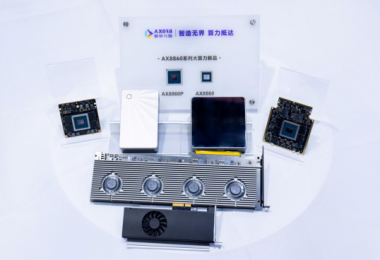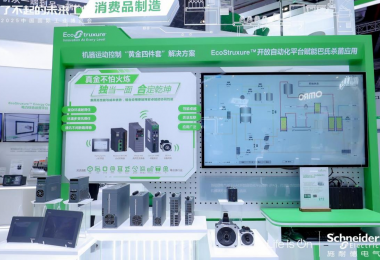

2026年10月12日,上海国家会展中心5.2H馆D008展台,爱芯元智以“智造无界,算力抵达”为主题亮相第26届中国国际工业博览会,不仅全景展示了面向物理AI的全场景算力产品矩阵,更正式推出重磅新品AX8860大算力边端AI芯片系列。作为专为大模型在边缘和端侧落地打造的大算力AI芯片,AX8860系列的发布标志着边端AI从技术验证阶段,跨入以业务价值为导向的端到端生产力落地新周期。
展会期间,爱芯元智创始人&董事长仇肖莘博士、边缘&终端计算产品线总经理刘瑞聚接受了包括本刊在内的多家媒体采访,首次对外详解了这款新品的技术逻辑、市场定位,以及公司“边-车-端”协同的平台型发展战略。
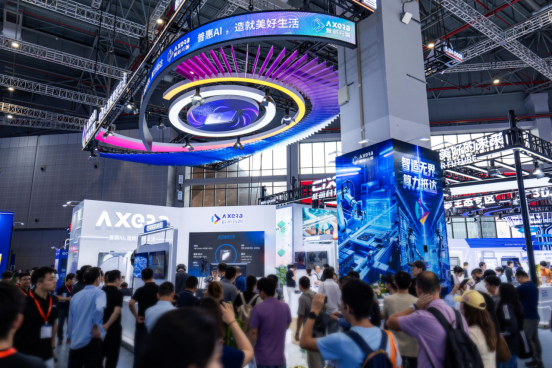
四大展区联动,全景展现物理AI落地硬实力
本届工博会,爱芯元智设置核心算力与技术底座、行业解决方案、软件架构与工具链、生态与价值共创四大展区,集中呈现面向物理AI的全场景算力方案。以AX8860为核心,公司展示了从芯片、核心模组到推理卡、推理服务器等一系列产品形态,可为智能智造提供从算力底座到应用部署的强力支撑。
在生态与价值共创展区,爱芯元智合作伙伴原力灵机携自研的DM0.5通用具身大脑亮相,集中展示了接口插拔质检、Insert Anything通用工业插入和灵巧手柔性切削三个任务,生动呈现了具身智能在电子装配、精密制造、工业质检及柔性加工等场景中的应用潜力。作为本次展示的智能核心,DM0.5依托爱芯大算力平台完成模型推理,为三类任务提供统一的智能支撑。
随着大模型、智能体和具身智能持续发展,AI正从信息世界走向物理世界,边缘和端侧算力也成为智能智造实现实时响应的重要基础。对于严苛的工业现场而言,爱芯元智认为,现场智能的完整闭环必须同时满足“看得见、算得准、反应快、稳定执行”四项要求。只有现场设备实现了“感知—判断—执行”的闭环处理,智能才能在事件发生的最前沿即时响应,推动边端AI真正转化为驱动产业升级的新质生产力。
跳出参数内卷,以均衡设计锚定边端大模型真实需求
不同于行业常见的“峰值算力优先”设计思路,AX8860从定义之初就跳出了单一指标竞赛的逻辑。仇肖莘在交流中强调,芯片整体性能由短板决定,孤立拔高某一项参数只会形成体验瓶颈,这款芯片在算力、带宽、内存容量与功耗之间实现了系统性的均衡。
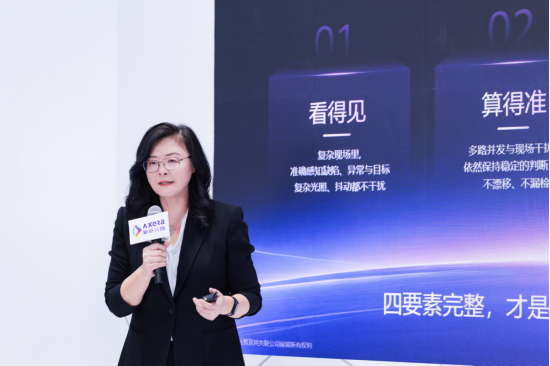
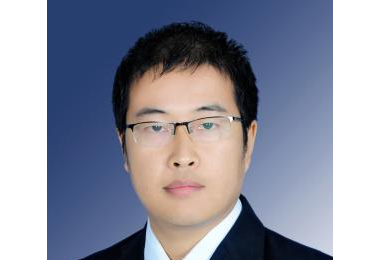
爱芯元智创始人&董事长仇肖莘博士
这款6nm工艺打造的芯片,搭载256TOPS混合精度算力并原生支持FP4,同时配备273GB/s内存带宽与最高128GB LPDDR5X大容量内存,这套规格组合的背后是清晰的产业需求锚定:芯片定义阶段团队就观察到大模型轻量化的明确趋势,千问27B、35B、A3B这类模型已经可以实现过去千亿、万亿参数级别的推理精度,因此AX8860的核心目标就是原生支持当前边缘场景落地最广泛的8B、9B、27B级模型,同时将Token吞吐锁定在30Token/s的可用门槛上,所有算力与带宽规格都经过多轮仿真验证确定,并非“拍脑袋”设定。
在与国际头部竞品的对比中,AX8860的差异化优势已经显现:即便目前刚完成基础Bring-Up调试,处于性能优化的早期阶段,其整体性能已经与国际头部平台基本持平,而满负载峰值功耗仅为竞品的45%。算力水平方面,既要关注峰值算力,还要关注架构效率,仇肖莘在采访中提到,采用GPGPU架构时,其计算单元利用率大致维持在30%-40%。而爱芯元智面向大模型设计的架构,算力利用率基本可以达到80%,同等峰值算力条件下,Prefill阶段性能能够实现2倍提升。针对Prefill与Decode两大核心推理阶段,芯片也做了针对性优化:Prefill阶段依靠扎实的算力基础保障效率,Decode阶段则凭借领先的带宽表现实现流畅吞吐。
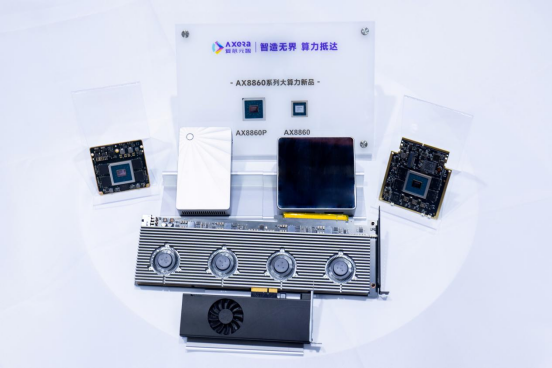
爱芯元智采用AXLink互联技术,可以高效的聚合芯片算力和内存带宽。同时,AX8860还支持64路视频解码、16路视频编码,可轻松适配工业场景中多路视觉感知与视频分析的并行处理需求。
目前AX8860已经进入送样阶段,后续软件栈的持续优化还将进一步释放性能,当前公布的实测数据可视为保底指标。围绕这款芯片,爱芯元智同步推出元曦模组A256S、元曦系列推理卡与推理服务器。A256S 采用模块化设计,具备体积小、算力强、落地快等特点,支持 LLM、VLM 和 Omni 等多类模型应用,能够为核心算力与应用硬件之间提供更灵活的组合方式,帮助客户加速产品研发落地。
打造平台型底座,穿越边缘AI碎片化市场挑战
边缘AI市场的高度碎片化,是所有芯片厂商都要面对的核心挑战。不同细分赛道的需求差异巨大,依靠单一芯片覆盖全部场景几乎不可能实现,而如果单赛道深耕,企业成长天花板又会非常明显。爱芯元智给出的解法是打造平台型企业,通过统一的技术底座支撑多条赛道并行发展。
这套技术底座的核心是由AI ISP IP、NPU IP、编解码IP等一系列核心IP构成的“技术工具箱”,不同业务线可以从工具箱中选取并组合不同IP,快速配置出适配对应领域的专用芯片,以相对可控的研发投入支撑多赛道拓展。
目前爱芯元智已经形成三条规模化量产的产品线:面向智能视觉处理的终端芯片,主打复杂光照环境下的高质量图像采集,支持1200万至1600万像素工业相机接入,单颗芯片自带最高18TOPS算力,在成熟的视觉处理市场走技术驱动的中高端路线,不参与价格战;智能驾驶车载芯片,拥有完备的产品矩阵,在行业主流采用6纳米制程时率先落地5纳米工艺,推出算力超过700TOPS的国产车载智驾芯片,同时覆盖入门级性价比产品与高端旗舰产品; 以AX8860为核心的边缘计算产品线,切入尚处起步阶段、竞争格局尚未定型的边端大模型推理赛道。
三大业务线并非孤立发展,而是形成清晰的生态循环:最早落地的视觉处理芯片作为业务基座,支撑车载与边缘计算业务成长,待三者全部成熟后,将共同支撑第四条增长曲线的开拓。
坚持Tier2中立定位,构建开放共生的产业协作生态
在行业普遍追求端到端垂直整合的当下,爱芯元智始终坚持清晰的Tier2定位:只专注芯片研发,绝不涉足上层算法开发。仇肖莘认为,这种“边界清晰”的中立模式,恰恰是边缘碎片化市场中最具生命力的协作方式。
如果芯片厂商选择垂直整合,就意味着要在每一个细分赛道都开发全套解决方案,在高度碎片化的边缘场景中,这几乎是不可能完成的任务,同时也会让大量合作伙伴失去合作安全感。而爱芯元智坚持不做上层算法,算法厂商、系统集成商就可以安心基于其硬件平台开发方案,不用担心芯片厂商下场与自己竞争,生态协作的信任基础由此建立。
这种模式也恰好契合产业走向成熟后的软硬解耦趋势:在车载等赛道发展早期,端到端的整合方案可以帮助能力尚不完善的车企快速落地,但随着行业发展,算法能力逐步趋同,终端客户开始更倾向于自主选择算法,同时拥有易用的通用硬件平台,避免被单一供应商锁定。爱芯元智的开放策略恰好适配这一趋势,目前其开源生态已经完成260多个主流模型的部署,所有适配完成的模型代码都可在GitHub上获取,普通开源模型最快1-2天即可完成部署,复杂度较高的模型也仅需一两周就能完成优化。
针对系统厂商的垂直整合趋势,仇肖莘也表示,行业始终存在周期性的“整合-拆分”循环,芯片企业的独立价值不会消失。爱芯元智也可以为车企、系统厂商提供定制化芯片服务,依托自有IP库,根据客户的规格定义完成半定制芯片开发,与系统厂商的自研芯片团队形成互补而非直接竞争。
写在最后
从工业产线的实时缺陷检测,到企业内部的本地大模型部署规避数据上传云端的安全风险,再到未来像路由器一样普及的家庭端本地智能体盒子,边端AI的爆发场景正在逐步清晰。随着AX8860的落地,爱芯元智正在将“算力抵达现场”从口号变为现实:数据在何处产生,计算就在何处发生,让AI在事件发生的最前沿即时完成感知、判断与执行,最终把边缘算力转化为真实可感的产业新质生产力。
正如仇肖莘在发布现场所言:“算力不必远在天边,智能就该近在眼前。”从云端到现场,让智能回到事情发生的地方——这或许正是边端AI从技术验证走向规模落地的核心要义。